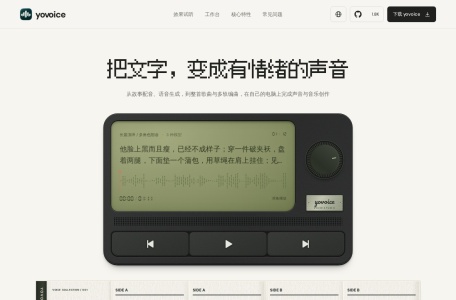
Yovoice 是一款开源的本地AI语音合成工具,核心能力是离线文字转语音、音色克隆和情绪语气调节,提供桌面图形客户端与命令行两种使用方式。它把语音推理全部放在本机完成,文稿、音色和音频文件都不经过第三方服务器,这一点和常见网页版 TTS 服务走的是完全不同的路子。下面按定位、使用体验和常见问题来梳理,适合正在找本地配音方案的内容创作者和技术用户参考。
本地AI语音合成工具的定位与核心特点
它不是”又一个在线配音网站”,而是需要安装到自己电脑上的工具,图形界面和 CLI 共用同一套模型和音色库。功能大致可以拆成几块。
- 声音克隆:给一段参考音频就能提取声线,也可以用文字描述生成虚拟音色,克隆结果能反复调用。
- 情绪调控:情绪预设、强度滑块、文本提示词、参考音频演绎几种方式都能改语气,还支持笑声一类非语言标签,机械朗读感会弱一些。
- 多语种与方言:中、英、法、日等语种可以覆盖,方言配音也有对应支持。
- 多模型兼容:兼容 IndexTTS、VoxCPM2、Qwen3-TTS、Kokoro-82M 等开源模型,各自偏向不同——有的强在情绪表现,有的更适合精细克隆,轻量模型则胜在启动快。
- 双工作流:普通用户在工作台里选音色、预览波形、导出音频;开发者走 CLI 批量渲染,便于接入自动化流程。
真正拉开差距的还是本地推理这一条。未公开稿件、自制角色声线这类素材,不上传云端用起来心里更有底。软件本体以 Apache-2.0 协议开源,不按字符或时长计费,但具体授权范围与是否有其他付费项,以官方页面说明为准。
使用体验:离线配音流程与适用人群
从官网(yovoice.leemysw.com)或 GitHub 仓库拿安装包,首次安装需要联网拉取模型权重,部署完成后断网也能生成。流程本身不复杂:导入参考音频或选内置音色,贴入文稿,调整情绪,预览后导出。
门槛主要在硬件。macOS 仅支持 Apple Silicon,Windows 建议配 NVIDIA 显卡开启 CUDA 加速,低配机器等待时间会比较明显,模型权重还占一定磁盘空间。整体看,它更像”配置一次、长期用”的工具,而不是打开网页试两句就走的那种。
相对适合这几类人:
- 短视频、有声书、播客创作者,需要批量做旁白和多角色对话。
- 剧本、漫剧、AI 短剧团队,要快速产出试读音频和情绪版本。
- 技术开发者与 AI 爱好者,想本地部署 TTS 或给智能体加语音输出。
- 对稿件隐私敏感、希望离线完成合成的用户。
动手前有几件事值得先确认:
- 优先从官网或官方仓库获取安装包,下载后做一次本地安全扫描,来路不明的整合包不要用。
- 客户端与模型更新较快,安装前核对版本号与更新时间,避免两者不匹配。
- 生成内容能否商用要单独看所使用语音模型的许可协议,克隆他人声音需持有合法授权,各地对声音权和 AI 生成内容的合规要求不同,以当地法规及实际页面为准。
- 是否完全免费、模型下载是否顺畅,可能随版本调整,以实际页面为准。
常见问题 FAQ
- Yovoice 必须联网才能用吗?首次安装和下载模型需要网络,模型部署好之后断网也能合成,具体以实际版本说明为准。
- 没有独立显卡能跑吗?可以启动,但生成速度通常明显变慢;Windows 上配 NVIDIA 显卡并开启 CUDA 加速,体验会好不少。
- 克隆声音需要多少素材?官方给的说法是数秒参考音频即可提取声线,素材越干净、背景噪声越少,结果一般越稳定。
- 做出来的配音能商用吗?软件开源不等于内容可商用,要看所用语音模型的许可协议,克隆音色还得有原始声音的授权。
- 和网页版 TTS 最大的区别是什么?数据不出本机、没有按量计费的配额,代价是自己准备硬件和存储空间。
Yovoice 的价值在于把声音克隆、情绪控制和多模型切换收进了一个离线工具里,适合愿意为隐私和产出量折腾硬件的用户,对低配机器或只想随手试一段配音的人不算友好。把它当作常规配音流程之外的补充渠道,商用前结合合规渠道与授权确认,会更稳妥。